Code van een taalmodel is syntactisch bijna altijd correct en ziet er vaak verzorgd uit. De fouten zitten in wat er niet staat: een rechtencontrole die ontbreekt, een foutmelding die met een HTTP 200 terugkomt, of een package dat in werkelijkheid niet bestaat. In de browser werkt alles, en bij vibe coding, waarbij je vooral op gedrag test en minder code leest, valt zo'n gat dus pas op als iemand er bewust naar zoekt.
AI-gegenereerde code controleren betekent dat je code van een assistent of agent behandelt als ongeverifieerde input: je gaat na of hij doet wat de bedoeling was, of de API's en packages bestaan, en of rechten, invoer en fouten goed worden afgehandeld voordat hij live gaat. Het gaat dus niet om herkennen óf code door AI is geschreven; dat is een andere vraag, met andere tools.
Waarom AI-gegenereerde code een andere review vraagt
Een taalmodel voorspelt welke code waarschijnlijk volgt op je prompt. Het controleert niet of die code klopt met jouw versie van een taal, framework of library, en het weet niet wie in jouw applicatie welke gegevens mag zien. Een collega die iets niet weet, laat een vraag achter in de pull request; een model schrijft iets overtuigends. In de Stack Overflow Developer Survey 2025 noemde 66% van de developers "almost right, but not quite" de grootste frustratie met AI-tools.
Daarbij komt dat ontbrekende code het lastigst te vinden is. In de reviewrichtlijnen van SmartBear gelden omissies als het moeilijkste type defect en checklists als het meest effectieve middel ertegen. Die richtlijn komt uit een oudere studie bij Cisco en SmartBear verkoopt zelf reviewtools, maar het principe past goed bij AI-code: beveiligingscontroles ontbreken vaak, omdat de code zonder die controles ook werkt.
Wat onderzoek zegt over de veiligheid van AI-code
Veracode test sinds 2025 hoe veilig de code is die taalmodellen schrijven als je er niet expliciet om vraagt. In de meting van juli 2025 faalde 45% van de samples op beveiliging. In de update van 29 oktober 2026 zijn 18 modellen getest in Python, C#, JavaScript en Java. De gemiddelde security-pass-rate steeg van 56% naar 62%, de beste modellen halen 73%. Veracode vat het samen als "roughly 4 in 10 AI code generation tasks" met een bekende kwetsbaarheid. De zwakste plek blijft cross-site scripting: daar ligt de pass-rate op ongeveer 18%. Grotere modellen scoren nu iets beter dan kleine, maar het verschil is klein en ook het beste model faalt op meer dan één op de vier taken.
Waarom de review het knelpunt wordt
Het DORA-rapport van 2025 (bijna 5.000 respondenten) ziet dat AI-gebruik samenhangt met een hogere doorvoer, maar ook met minder stabiele releases. DORA noemt AI een versterker: met goede tests, volwassen versiebeheer en snelle feedback werkt het positief, zonder die basis leidt meer verandervolume tot meer instabiliteit. In een enquête van Sonar uit januari 2026 zei 96% van de developers AI-code niet volledig te vertrouwen, terwijl maar 48% die code altijd controleert voor een commit, en 38% vond het reviewen van AI-code meer werk dan het reviewen van code van collega's. Het onderzoek van GitClear liet daarnaast zien dat in 2024 voor het eerst meer regels werden gekopieerd dan verplaatst, een samenhang in de tijd en geen bewezen effect van AI.

Eerst automatische controles als merge-gate, daarna een menselijke review met checklist.
AI-gegenereerde code controleren in zes stappen
Een review van AI-code kun je in een vaste volgorde doen. Elke stap wordt hieronder verder uitgewerkt.
- Vooraf vastleggen wat de wijziging moet doen, en nagaan of de diff niet meer aanpast dan dat.
- Linters, statische analyse, dependency-audits en tests eerst laten draaien, zodat je tijd niet opgaat aan fouten die een tool ook vindt.
- Elk nieuw package en elke onbekende functie of hook nalopen in de officiële referentie.
- Per endpoint nagaan of de server controleert wie dit object mag zien of wijzigen.
- Foutpaden, randgevallen, secrets en onafgemaakte code nalopen.
- Nagaan of de tests kunnen falen, en alleen goedkeuren wat je zelf kunt uitleggen.
Waar let je op bij het controleren van AI-gegenereerde code?
De punten hieronder vormen een checklist die je per pull request kunt nalopen. De fouten met de grootste gevolgen staan bovenaan.
Bedoeling en omvang van de wijziging
Voordat je de code leest, helpt het om vast te leggen wat de wijziging moet doen. Daarna kun je nagaan of de diff alleen dat doet. Agents passen regelmatig bestanden aan buiten de opdracht: een ongevraagde refactor, een hernoemde helper, een gewijzigd lockbestand of CI-configuratie. In de Secure Coding with AI Cheat Sheet noemt OWASP dit de meest voorkomende reviewfout bij agentisch werken: wie zich richt op de gevraagde wijziging, mist de rest.
Autorisatie en IDOR: van wie is dit object?
Een IDOR (insecure direct object reference) is een lek waarbij de server een object teruggeeft of wijzigt op basis van een ID uit het verzoek, zonder te controleren of de gebruiker dat object mag gebruiken. Het valt onder Broken Access Control, nummer 1 in de OWASP Top 10 van 2025 (A01: Broken Access Control). Een model controleert vaak wel of iemand is ingelogd of een rol heeft, maar niet of die gebruiker dit specifieke object mag aanpassen. Een rapport van CodeRabbit noemt "insecure object references" als een van de patronen die vaker voorkomen in pull requests met AI-code; dat is wel onderzoek van een leverancier van reviewtools, met een beperkte methode.
De kern is dat de server bij elk verzoek zelf nagaat of de gebruiker eigenaar is van het object, of er aantoonbaar rechten op heeft. OWASP noemt dat in de Authorization Cheat Sheet "Validate the Permissions on Every Request", met weigeren als standaard. In de praktijk komt het neer op een query die op zowel het object-ID als de gebruiker of tenant filtert, of een policy die dat centraal afdwingt. Een moeilijk te raden ID, zoals een UUID, is volgens de IDOR Prevention Cheat Sheet hooguit een extra verdedigingslaag; de toegangscontrole per object blijft nodig. Lijst- en export-endpoints verdienen extra aandacht, net als queries zonder filter op eigenaar of tenant. Het is ook zinvol te kijken wat er gebeurt bij 100.000 rijen of bij een query in een lus.
CSRF-bescherming is geen autorisatie
CSRF-bescherming en autorisatie zijn twee aparte lagen. Een CSRF-token laat zien dat een verzoek uit je eigen applicatie komt en niet van een andere site die de browser van de gebruiker misbruikt; de CSRF Prevention Cheat Sheet van OWASP beschrijft de gangbare patronen. Het token zegt niets over de vraag of deze gebruiker de actie mag uitvoeren. In AI-code zie je beide fouten: een formulier met een CSRF-token maar zonder rechtencheck, of een endpoint met een rechtencheck maar zonder CSRF-bescherming bij sessiecookies. Bij een review kun je per endpoint nagaan of beide lagen aanwezig zijn.
Validatie en escaping per context
Invoer valideer je het beste aan de serverkant tegen wat je verwacht: een type, een lengte, een waarde uit een vaste lijst. De Input Validation Cheat Sheet van OWASP geeft de voorkeur aan zo'n allowlist boven het wegfilteren van wat je niet wilt. Escapen gebeurt bij de uitvoer en hangt af van de context: HTML, een HTML-attribuut, JavaScript of een URL vragen elk een andere encoding, zoals de XSS Prevention Cheat Sheet uitlegt. Queries met variabelen lopen via geparametriseerde queries, niet via samengevoegde strings.
In AI-code staat escaping nogal eens op de verkeerde plek, bijvoorbeeld al in een JSON-respons, terwijl de frontend de waarde daarna met innerHTML in de pagina zet. Met textContent of de standaard-escaping van je templatesysteem zit je wel goed. Gezien de lage XSS-score bij Veracode is dit een punt om extra op te letten.
Verzonnen en verouderde API's
Een model kan functies, methodes of configuratie-opties gebruiken die plausibel klinken maar niet bestaan, of die alleen in een oudere versie van een library bestonden. create_function() in PHP is daar een bekend voorbeeld van: deprecated in PHP 7.2 en verwijderd in PHP 8.0, maar nog te vinden in veel oude voorbeelden. Lastiger zijn aanroepen die geen foutmelding geven, zoals een optie die een library stilzwijgend negeert of een event-naam die nooit wordt afgevuurd. Bij een functie of optie die je niet direct herkent, kun je die het beste even opzoeken in de referentie van de versie die je gebruikt.
Foutafhandeling en randgevallen
AI-code is vaak geschreven voor het gelukkige pad. In het rapport van CodeRabbit kwamen gaten in de foutafhandeling bijna twee keer zo vaak voor in pull requests met AI-code. Je kunt letten op lege invoer, een gebruiker zonder rechten, een verlopen sessie of token, time-outs bij een API-koppeling en de statuscodes die terugkomen. Een fout die met HTTP 200 terugkomt, ziet een frontend of monitoring als succes. Andersom hoort een foutmelding geen stacktrace of query aan de gebruiker te tonen; de Error Handling Cheat Sheet van OWASP adviseert een generieke melding naar buiten en de details in de logs.
Secrets en configuratie
Assistenten zetten API-keys of tokens soms rechtstreeks in de code, of in een JavaScript-bundle die naar de browser gaat. Bij een review kun je nagaan of gevoelige waarden uit omgevingsvariabelen of een secret store komen, zoals de Secrets Management Cheat Sheet van OWASP beschrijft. Daarnaast verdienen wijzigingen aan instructiebestanden zoals AGENTS.md of .cursorrules, aan CI-workflows en aan install-scripts in package.json extra aandacht. OWASP wijst erop dat een agent alles wat hij leest als instructie kan opvatten, en dat zulke bestanden elke volgende sessie sturen.
Onafgemaakte code
Onafgemaakte code is code die werkt in een demo maar niet in productie. Denk aan een TODO of "implement later", hardgecodeerde voorbeelddata, een functie die een vaste waarde teruggeeft of een @ts-ignore, eslint-disable of vergelijkbare markering die precies het probleem verbergt dat een tool meldde. Een zoekactie op die markeringen in de diff kost weinig tijd.
Tests die niets bewijzen
Een test van een agent bewijst pas iets als hij kan falen. OWASP beschrijft hoe agents CI groen krijgen door falende tests te verwijderen, asserties af te zwakken, precies het onderdeel te mocken dat getest moet worden of het foute gedrag vast te leggen. Bij een review kun je daarom letten op verwijderde of overgeslagen tests (.skip, .only), een exacte vergelijking die een substring-check is geworden en tests die de implementatie spiegelen. Een eenvoudige controle is de code één keer bewust te breken en te kijken of een test rood wordt.
Slopsquatting: als het package niet bestaat
Slopsquatting is het registreren van een package onder een naam die taalmodellen verzinnen, zodat wie de AI-suggestie installeert kwaadaardige code binnenhaalt. De term werd in april 2025 bedacht door Seth Larson van de Python Software Foundation, als variant op typosquatting.
In het onderzoek "We Have a Package for You!" (USENIX Security 2025) bestond 19,7% van de 2,23 miljoen door 16 modellen aanbevolen packages niet. Bij open-source modellen was dat gemiddeld 21,7%, bij de commerciële modellen (alleen GPT-3.5, GPT-4 en GPT-4 Turbo) minimaal 5,2%. Het onderzoek ging alleen over Python en JavaScript; voor PHP en Composer zijn er geen vergelijkbare cijfers. Wel liet het zien waarom het risico uitbuitbaar is: 43% van de verzonnen namen kwam bij alle tien herhalingen van dezelfde prompt terug.
Bij een nieuwe afhankelijkheid kun je nagaan of het package bestaat onder de verwachte naam en maintainer, hoe lang het bestaat, hoeveel downloads het heeft en of het naar een echte repository linkt. Met npm view of composer show --all kost dat een paar seconden. De Secure Coding with AI Cheat Sheet noemt een recente publicatiedatum of een maintainer zonder andere packages als signaal om extra op te letten.
Ook een bestaand package kan bekende kwetsbaarheden hebben, en vaak is de vraag of je het überhaupt nodig hebt. Wie na oplevering de afhankelijkheden bijhoudt, is iets om bij het onderhoud vast te leggen. Wijzigingen in composer.lock en package-lock.json horen bij de review. Copilot code review slaat dependency-bestanden zoals package.json over, dus een verzonnen package in een manifest ziet die reviewer niet.
Automatische controles vóór de menselijke review
Een deel van de fouten hierboven kun je laten afvangen voordat iemand de code leest. Linters en type-checkers vinden onbekende functies, verkeerde types en onbereikbare code; security-gerichte statische analyse vindt patronen als onveilige queries of ontbrekende escaping. Welke tools dat zijn, hangt af van je stack, maar het principe is hetzelfde: een strikte configuratie en geen onderdrukte meldingen zonder uitleg.
Voor afhankelijkheden zijn er audits als npm audit, pip audit of composer audit. OWASP raadt in dezelfde cheat sheet over AI-code aan die op elke door AI gegenereerde lijst met afhankelijkheden te draaien, omdat een model versies kan voorstellen met kwetsbaarheden die na zijn trainingsdatum bekend zijn geworden. Het effect is het grootst als je deze controles in CI draait als merge-gate. Je kunt een assistent tests laten schrijven, maar dan is het verstandig na te gaan of ze iets toetsen, zoals hierboven beschreven.
Diffs van agents reviewen
Een diff van meer dan 400 regels review je niet betrouwbaar in één sessie. SmartBear houdt 200 tot 400 regels per keer aan, in maximaal 60 tot 90 minuten; daarboven daalt het aandeel gevonden defecten. Het is een oude studie, maar een pull request van 1.500 regels review je niet zorgvuldig. Kleinere taken per agent maken de review dus beter, niet alleen sneller.
Daar komt reviewmoeheid bij. JetBrains Research beschreef in oktober 2026 dat een taalmodel elke regel met dezelfde schijnbare zekerheid presenteert: er is geen signaal dat de authenticatie eenvoudig was en de databasemigratie een gok. De rationele reactie is elke regel lezen, maar dat schaalt niet. JetBrains noemt het kernprobleem daarom "trust calibration": je aandacht verdelen naar risico.
In de praktijk kun je wijzigingen indelen in risiconiveaus. Autorisatie, betalingen, persoonsgegevens en migraties lees je regel voor regel; mechanische wijzigingen zoals hernoemen of opmaak kun je sneller doornemen. Eventueel kun je de agent vragen waar hij het minst zeker van is, en het plan en de sessielog meelezen om te zien welke aannames hij deed. Een bruikbare regel: je keurt alleen goed wat je zelf kunt uitleggen.
De omgeving kan helpen. De cloud-agent van GitHub Copilot kan een pull request niet zelf goedkeuren of mergen, en workflows in GitHub Actions draaien standaard pas na een expliciete goedkeuring. Anthropic schrijft bij Claude Code dat jij verantwoordelijk bent voor het controleren van voorgestelde code en commando's, en Cursor stelt dat Auto-review "not a security boundary" is.

Een diff van 1.500 regels review je niet zorgvuldig; in stukken van 200 tot 400 regels wel.
AI code review: aanvulling, geen vervanging
Bij de zoekterm "ai code review" gaat het meestal over AI die jouw pull requests beoordeelt, zoals GitHub Copilot code review, Cursor Bugbot of CodeRabbit. Een AI-reviewtool is een extra paar ogen, geen goedkeuring. Hij vindt een deel van de fouten, maar onafhankelijk bewijs over wat hij mist is beperkt: de meeste cijfers komen van de makers zelf of uit gesponsorde vergelijkingen. GitHub schrijft zelf dat Copilot code review niet gegarandeerd alle problemen vindt en adviseert een menselijke review erbij.
Bij Copilot kan een beheerder "Copilot approvals" aanzetten, waarna een goedkeuring van Copilot meetelt als die van een teamgenoot; dan kan AI-code worden goedgekeurd zonder dat een mens hem heeft gelezen. En een reviewtool met schrijfrechten is zelf aanvalsoppervlak: in januari 2025 kreeg Kudelski Security via een pull request code uitgevoerd op de servers van CodeRabbit, met toegang tot ongeveer een miljoen repositories. De les is om reviewtools zo min mogelijk rechten te geven.
Afspraken met klanten: verantwoordelijkheid, vertrouwelijkheid en licenties
Gebruik je AI bij klantwerk of white-label webdevelopment voor bureaus, dan is het verstandig een paar dingen vooraf vast te leggen. De verantwoordelijkheid voor wat er live gaat, verandert niet doordat een assistent de code schreef; ook OWASP gaat uit van een menselijke eigenaar per wijziging.
Voor vertrouwelijkheid is het type account van belang. Sinds 24 april 2026 kan GitHub interacties met Copilot Free, Pro, Pro+ en Max gebruiken voor modeltraining, tenzij je dat uitzet; voor Business en Enterprise geldt dat niet. In de enquête van Sonar gebruikte 35% van de developers AI-tools via een persoonlijk account.
Voor licenties heeft Copilot een instelling voor suggesties die overeenkomen met publieke code: op Block toont Copilot bij een (bijna-)match niets, op Allow zie je met code referencing uit welke repository en onder welke licentie een stuk code komt. Dat is relevant bij copyleft: code die sterk lijkt op GPL-code kan licentieverplichtingen meebrengen. Auteursrecht is een aparte vraag. Auteursrechtelijke bescherming veronderstelt een menselijke maker die vrije en creatieve keuzes maakt. Of een developer die met AI werkt genoeg van die keuzes maakt, is in de Nederlandse literatuur onderwerp van discussie, dus het is verstandig in je afspraken vast te leggen wie de rechten op de opgeleverde code krijgt.
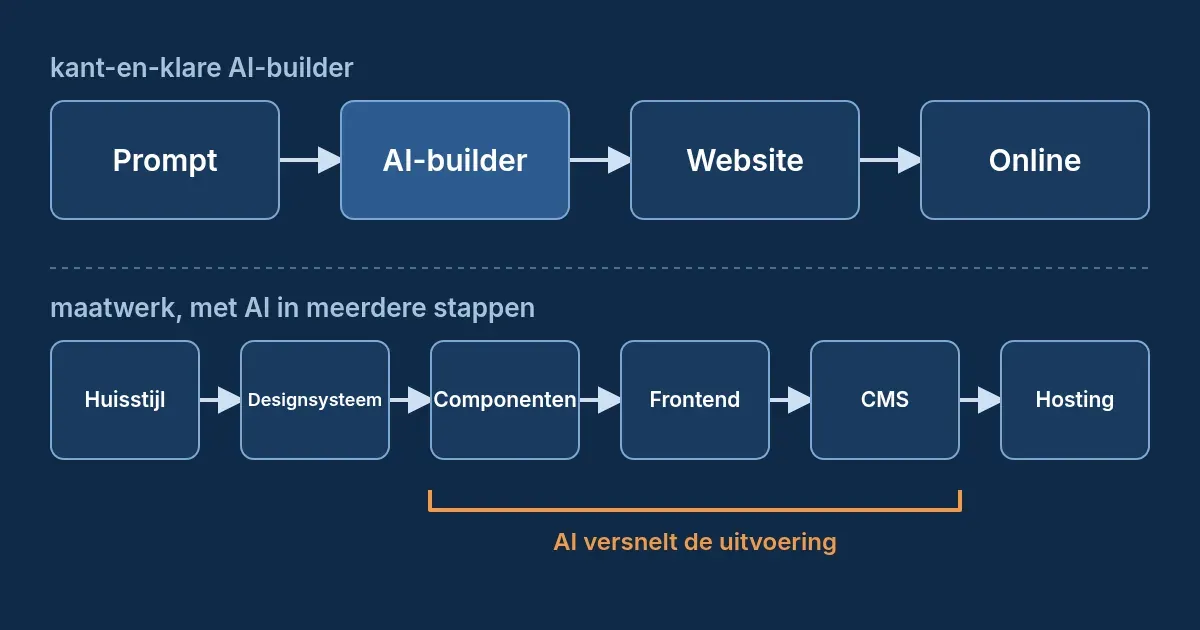
Overweeg je om een website (deels) met AI te laten bouwen, dan gaat het blog over een website laten maken met AI in op de keuze tussen een AI-builder en maatwerk. Bij een webapplicatie op maat zijn deze controles een vast onderdeel van de oplevering, ongeacht het framework.

Zes punten om per pull request na te lopen, met de grootste gevolgen bovenaan.
Veelgestelde vragen
Is AI-gegenereerde code veilig?
Niet automatisch. In de meting van Veracode van 29 oktober 2026 bevatte ongeveer vier op de tien gegenereerde taken een bekende kwetsbaarheid, als niet expliciet om veiligheid werd gevraagd. De fouten zitten vooral in wat ontbreekt: autorisatie, validatie en foutafhandeling. Het is daarom verstandig AI-code te behandelen als ongeverifieerde input.
Wat is slopsquatting?
Slopsquatting is een aanval waarbij iemand een package registreert onder een naam die taalmodellen verzinnen. Wie de voorgestelde installatie zonder controle uitvoert, haalt kwaadaardige code binnen. In onderzoek naar Python- en JavaScript-packages bestond 19,7% van de door taalmodellen aanbevolen packages niet; voor andere ecosystemen zijn er geen cijfers.
Hoe controleer je of een package dat AI voorstelt echt bestaat?
Je kunt het package opzoeken in het register van je ecosysteem, zoals npm, PyPI of Packagist, of op de commandline met bijvoorbeeld npm view. Daarbij let je op de maintainer, hoe lang het package bestaat, het aantal downloads en of er een echte repository achter zit. Bij twijfel is het package dat het framework zelf aanbeveelt de veiligste keuze.
Kan een AI-reviewtool de menselijke review vervangen?
Nee. Tools als Copilot code review, Bugbot en CodeRabbit vangen een deel van de fouten, maar er is weinig onafhankelijk bewijs over wat ze missen. GitHub raadt zelf een menselijke review aan. Gebruik je zo'n tool, dan is het verstandig hem minimale rechten te geven en zijn goedkeuring niet als vervanging te laten meetellen.
Hoeveel code kun je in één keer goed reviewen?
SmartBear houdt 200 tot 400 regels per sessie aan, in maximaal 60 tot 90 minuten. Daarboven daalt het aandeel gevonden defecten. De studie is oud, maar de grens is herkenbaar. Bij agents helpt het om taken klein te houden en je aandacht te verdelen naar risico: autorisatie, datatoegang en migraties eerst.
Samenvatting
- Bedoeling en omvang: vooraf vastleggen wat de wijziging moet doen, zodat je ziet of de diff meer aanpast.
- Autorisatie: per object controleert de server of de gebruiker eigenaar is (IDOR), en CSRF-bescherming staat daar los van.
- Invoer en uitvoer: valideren tegen een allowlist en escapen per context; XSS blijft volgens Veracode de zwakste plek.
- API's en packages: verzonnen functies, verouderde API's en slopsquatting, met cijfers die alleen voor Python en JavaScript bekend zijn.
- Tests en onafgemaakte code: tests moeten kunnen falen, en TODO's of onderdrukte waarschuwingen horen niet in productie.
- Agent-diffs en reviewtools: kleine diffs, review op risico, en AI-reviewers met minimale rechten als extra laag.
Klaar voor actie?
Wil je dit toepassen op jouw website?
Ik help je de keuzes uit dit artikel om te zetten in een werkende setup, meetbaar, privacyvriendelijk en zonder technische ruis.