Een RegEx-tabel (RegEx Table) is een variabele in Google Tag Manager (GTM) waarmee je verschillende invoerwaarden kunt herkennen op basis van een patroon. Je kunt vervolgens aan zo'n patroon een vaste uitvoerwaarde koppelen.
Een RegEx-tabel is bijvoorbeeld handig wanneer je alle URL's die met /blog/ beginnen wilt herkennen. Je hoeft dan niet iedere URL afzonderlijk in je GTM-configuratie op te nemen. Met één patroon kun je alle pagina's onder /blog/ herkennen.
Dit is het belangrijkste verschil met een Lookup-tabel. Een Lookup-tabel gebruik je vooral wanneer je een beperkt aantal concrete waarden aan andere waarden wilt koppelen. Een RegEx-tabel gebruik je wanneer je op basis van een patroon wilt bepalen welke waarden bij elkaar horen.
Wat is RegEx?
RegEx is een afkorting van Regular Expression, in het Nederlands een reguliere expressie. Dat klinkt ingewikkeld en soms is het ook echt compleet onleesbaar. Een reguliere expressie is simpel gezegd een zoekpatroon voor tekst.
Je kunt een reguliere expressie zien als een soort zoekopdracht waarbij je niet precies hoeft te weten welke tekst je zoekt. Je beschrijft in plaats daarvan waar de tekst aan moet voldoen.
Stel dat je deze drie URL's hebt:
/blog/google-tag-manager/
/blog/google-analytics/
/blog/gtm-variabelen/
Je zou iedere URL afzonderlijk kunnen opgeven. Maar eigenlijk hebben ze allemaal iets gemeenschappelijks: ze beginnen met /blog/.
Met een RegEx-patroon kun je dat gemeenschappelijke deel beschrijven:
^/blog/Dit patroon betekent: de tekst moet beginnen met /blog/.
Daarmee kunnen alle drie de bovenstaande URL's worden herkend, zonder dat je ze afzonderlijk hoeft op te nemen.
Wanneer gebruik je een RegEx-tabel?
Een RegEx-tabel is vooral handig wanneer je meerdere invoerwaarden hebt die volgens dezelfde structuur kunnen worden herkend.
Denk bijvoorbeeld aan:
- URL's die met een bepaalde map beginnen;
- verschillende subdomeinen;
- product-ID's met een bepaalde structuur;
- formulieren waarvan de ID's een gemeenschappelijk patroon hebben;
- waarden uit de datalayer waarvan een deel steeds hetzelfde is.
Je voorkomt hiermee dat je voor iedere afzonderlijke waarde een aparte regel moet maken.
Praktijkvoorbeeld: URL's categoriseren
Stel dat je de pagina's op je website wilt indelen in categorieën. Je gebruikt hiervoor de ingebouwde variabele Page Path als invoervariabele.
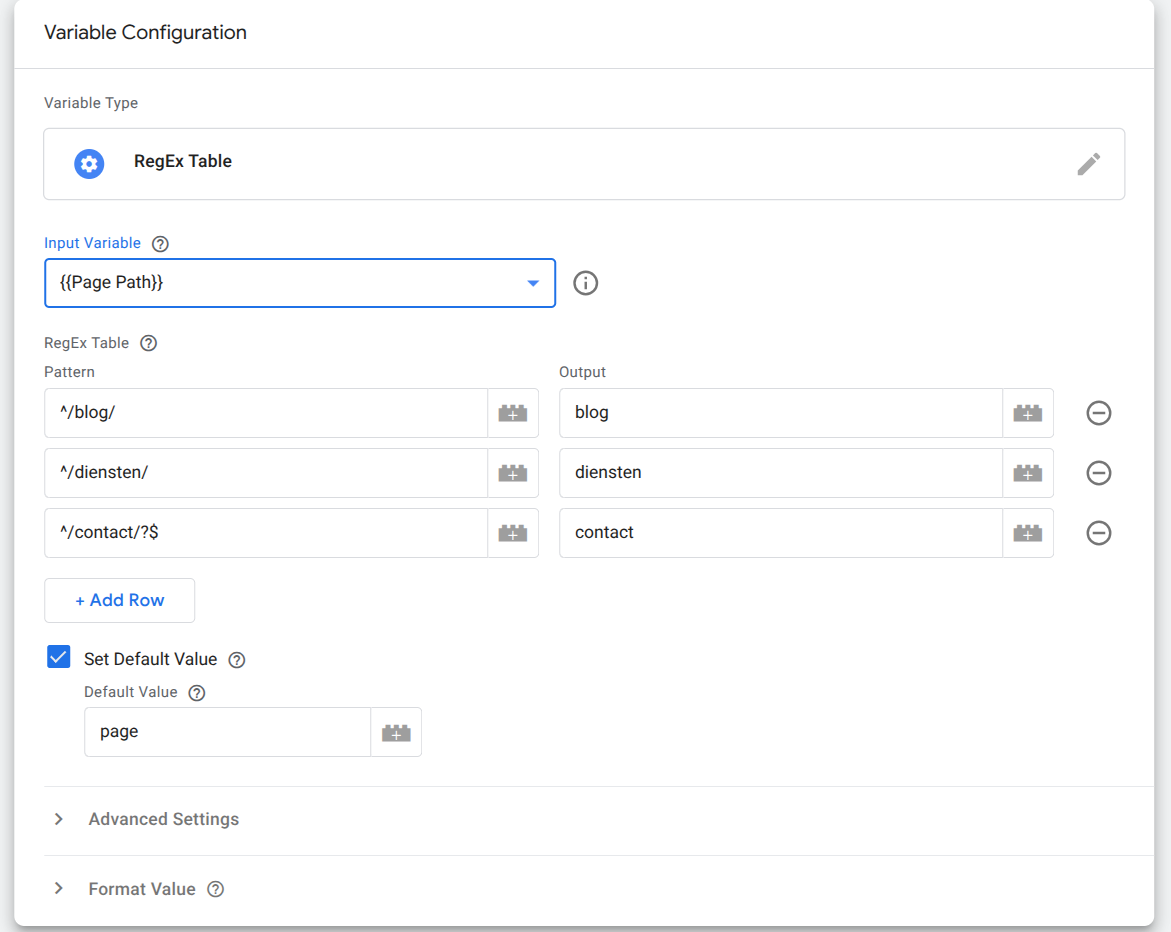
Je kunt bijvoorbeeld de volgende regels gebruiken:
| RegEx-patroon | Uitvoer |
|---|---|
^/blog/ |
Blog |
^/diensten/ |
Diensten |
^/contact/?$ |
Contact |
Komt bijvoorbeeld de URL /blog/google-tag-manager/ binnen, dan herkent GTM het patroon ^/blog/ en geeft de RegEx-tabel de waarde Blog terug.
Hetzelfde patroon werkt ook voor bijvoorbeeld:
/blog/google-analytics/
/blog/gtm-variabelen/
/blog/conversies-meten/
Al deze URL's krijgen dezelfde uitvoerwaarde: Blog.
Hoe lees je een RegEx-patroon?
Een RegEx-patroon bestaat uit speciale tekens die aangeven waar je naar wilt zoeken. Je hoeft niet meteen alle mogelijkheden van RegEx te kennen. Met een paar onderdelen kun je al veel praktische situaties oplossen.
Een veelgebruikt voorbeeld is:
^/blog/Hierin heeft ^ een speciale betekenis. Het betekent dat het patroon aan het begin van de invoer moet staan.
Het gedeelte /blog/ is gewone tekst. De combinatie betekent dus:
Begin van de tekst + /blog/Een URL als /blog/google-tag-manager/ voldoet hieraan, maar /categorie/blog/ niet.
Veelgebruikte RegEx-tekens
Onderstaande tekens kom je regelmatig tegen wanneer je RegEx gebruikt in Google Tag Manager:
| RegEx | Betekenis | Voorbeeld |
|---|---|---|
^ |
Begin van de invoer | ^/blog/ |
$ |
Einde van de invoer | /contact$ |
. |
Willekeurig teken | p.st |
.* |
Willekeurig aantal tekens | /blog/.* |
+ |
Eén of meer keer | a+ |
? |
Nul of één keer | /? |
(...) |
Groepering of capture-groep | (blog|nieuws) |
| |
Of | blog|nieuws |
Je hoeft deze syntax niet uit je hoofd te leren. Voor eenvoudige GTM-configuraties zijn ^, $ en .* vaak al voldoende.
Een eenvoudig voorbeeld met .*
Het patroon ^/blog/ is in veel gevallen voldoende. Je kunt ook expliciet aangeven dat er na /blog/ nog tekst mag volgen:
^/blog/.*Hier betekent .* dat er na /blog/ nog nul of meer willekeurige tekens mogen staan.
Dit patroon kan daardoor bijvoorbeeld overeenkomen met:
/blog/
/blog/google-tag-manager/
/blog/google-analytics/
Voor veel praktische toepassingen maakt het niet veel verschil of je ^/blog/ of ^/blog/.* gebruikt. Welke variant het beste is, hangt af van de instellingen van je RegEx-tabel en wat je precies wilt matchen.
De volgorde van regels is belangrijk
GTM controleert de regels van een RegEx-tabel van boven naar beneden. Zodra een patroon overeenkomt, wordt de bijbehorende uitvoer gebruikt.
Daarom kan een algemeen patroon een specifieker patroon onderscheppen.
Stel dat je deze regels gebruikt:
^/blog/.*       → Blog
^/blog/seo/.*   → SEO
De URL /blog/seo/google-tag-manager/ voldoet al aan het eerste patroon. GTM geeft daarom Blog terug en komt niet meer toe aan de tweede regel.
Wil je SEO-pagina's apart classificeren, zet het specifieke patroon dan boven het algemene patroon:
^/blog/seo/.*   → SEO
^/blog/.*       → Blog
De regel is eenvoudig: zet specifieke patronen boven algemene patronen.
Alleen volledige overeenkomsten
De RegEx-tabel heeft een instelling Alleen volledige overeenkomsten. Deze instelling bepaalt of het patroon de volledige invoer moet overeenkomen.
Je kunt dit verschil het beste zien aan de hand van een voorbeeld. Stel dat je alleen exact /contact of /contact/ wilt herkennen.
Je kunt daarvoor bijvoorbeeld dit patroon gebruiken:
^/contact/?$Hier betekent:
^: begin van de invoer;/contact: de tekst die je wilt herkennen;/?: een optionele slash;$: einde van de invoer.
Hierdoor wordt bijvoorbeeld /contact en /contact/ herkend, maar niet /contact/over-ons/.
Hoofdlettergebruik
Bij een RegEx-tabel kun je instellen of hoofdletters en kleine letters verschillend moeten worden behandeld. Met Hoofdlettergebruik negeren kun je ervoor zorgen dat bijvoorbeeld /Blog/ en /blog/ hetzelfde worden behandeld.
Welke instelling je gebruikt, hangt af van de gegevens die je verwerkt. Het is verstandig om hier bewust over na te denken wanneer je een RegEx-patroon maakt.
Capture-groepen
RegEx kan meer dan alleen bepalen of een tekst overeenkomt met een patroon. Je kunt ook een gedeelte van de invoer uit de tekst halen. Dit doe je met een capture-groep.
Een capture-groep herken je aan ronde haakjes.
Bijvoorbeeld:
^/product/([^/]+)Stel dat de invoer is:
/product/laptopHet gedeelte laptop wordt door de capture-groep vastgelegd. In de uitvoer kun je deze waarde vervolgens aanspreken met $1.
Capture-groepen zijn handig wanneer je een deel van de invoer wilt hergebruiken. Voor eenvoudige RegEx-tabelletjes heb je ze meestal niet nodig.
Een standaardwaarde instellen
Je kunt een standaardwaarde instellen voor situaties waarin geen enkel patroon overeenkomt met de invoer.
Bijvoorbeeld:
^/blog/       → Blog
^/diensten/   → Diensten
^/contact/?$  → Contact

Geen overeenkomst → Overig
Wanneer een pagina niet aan één van de patronen voldoet, geeft de variabele dan Overig terug.
Een standaardwaarde is nuttig wanneer je de uitkomst van de RegEx-tabel bijvoorbeeld als parameter naar een analytics-platform stuurt. Nieuwe of onverwachte invoer krijgt dan alsnog een herkenbare waarde.
RegEx testen
Wanneer je nog weinig ervaring hebt met reguliere expressies, kan het lastig zijn om direct te zien of een patroon doet wat je verwacht.
Je kunt een RegEx daarom eerst buiten Google Tag Manager testen met RegEx101. Daar kun je een patroon invoeren en direct zien welke delen van een tekst worden herkend.
Stel bijvoorbeeld dat je dit patroon wilt testen:
^/blog/Vervolgens kun je verschillende URL's invoeren om te controleren welke wel en niet overeenkomen. Dit is vooral handig wanneer je een complexer patroon maakt.
Let er wel op dat de manier waarop een reguliere expressie wordt verwerkt afhankelijk kan zijn van de omgeving waarin je deze gebruikt. Gebruik RegEx101 daarom vooral om je patroon te begrijpen en te controleren. Test het uiteindelijke resultaat daarna altijd in Google Tag Manager zelf.
RegEx-tabel testen in GTM
Test de uiteindelijke RegEx-tabel altijd in de Preview-modus van Google Tag Manager.
Controleer bij verschillende events:
- welke waarde de invoervariabele bevat;
- welk RegEx-patroon overeenkomt;
- welke uitvoer de RegEx-tabel geeft;
- wat er gebeurt wanneer geen patroon overeenkomt;
- wat er gebeurt wanneer meerdere patronen op dezelfde invoer kunnen passen.
Zo voorkom je dat een RegEx-patroon in je analytics-implementatie andere waarden opvangt dan je bedoeld had.
RegEx-tabel of Lookup-tabel?
Het verschil is vooral de manier waarop je de invoer wilt herkennen.
Gebruik een Lookup-tabel wanneer je een beperkt aantal concrete waarden aan andere waarden wilt koppelen.
Bijvoorbeeld:
quote-form → OfferteformulierGebruik een RegEx-tabel wanneer je meerdere waarden op basis van een gemeenschappelijk patroon wilt herkennen.
Bijvoorbeeld:
^/blog/ → BlogDit patroon kan vervolgens tientallen of honderden verschillende blog-URL's herkennen.
Twijfel je welke tabel je nodig hebt? Lees dan ook Lookup-tabel in Google Tag Manager.
Conclusie
Een RegEx-tabel is vooral nuttig wanneer je niet iedere invoerwaarde afzonderlijk wilt vastleggen, maar waarden op basis van een gemeenschappelijk patroon wilt herkennen.
Voor eenvoudige situaties hoef je maar een paar RegEx-onderdelen te kennen. Begin bijvoorbeeld met ^ om het begin van een waarde aan te geven en gebruik .* wanneer daarna nog willekeurige tekst mag volgen.
Maak je patroon eerst zo eenvoudig mogelijk, test het eventueel met RegEx101 en controleer daarna altijd het uiteindelijke resultaat in de GTM Preview-modus.
Meer over variabelen in Google Tag Manager lees je in Wat is een variabele in Google Tag Manager?.
Klaar voor actie?
Wil je dit toepassen op jouw website?
Ik help je de keuzes uit dit artikel om te zetten in een werkende setup, meetbaar en zonder technische ruis.